概要
YouTubeコメントを分析するためのAIダッシュボードを構築。課題定義からコメントデータ解析、可視化まで一貫したデータパイプラインを実現。
1. 課題定義
クライアントのYouTubeチャンネルより有用なコメントデータを抽出し、チャンネルの活性化を目指す
2. データ解析
コメントデータの前処理と特徴量を抽出
3. 可視化
インタラクティブなダッシュボードによるデータ可視化
4. AI活用(予定)
Embeddingとベクトル検索による類似コメント抽出
主な機能・工夫ポイント
1. データ前処理とクレンジング
YouTubeコメントデータに対して、以下の前処理を実行
- 重複コメントの除去
- テキストの正規化(大文字小文字、記号処理)
- 感情分析によるコメント分類(予定)
2. ベクトル検索による類似コメント抽出
OpenAIのEmbedding APIを使用してコメントをベクトル化し、pgvectorによる高速な類似度検索を可能に
- コメントの意味的類似度を計算
- COS距離による類似コメントの抽出
- k近傍探索による関連コメントの推薦
- リアルタイムでの検索機能
3. インタラクティブなダッシュボードUI
ユーザーが直感的にデータを探索できるUIを提供
- リアルタイムでのコメント統計表示
- 時系列でのコメント数推移グラフ
- 感情分析結果の可視化
- 類似コメントクラスターの可視化
- フィルタリング・ソート機能
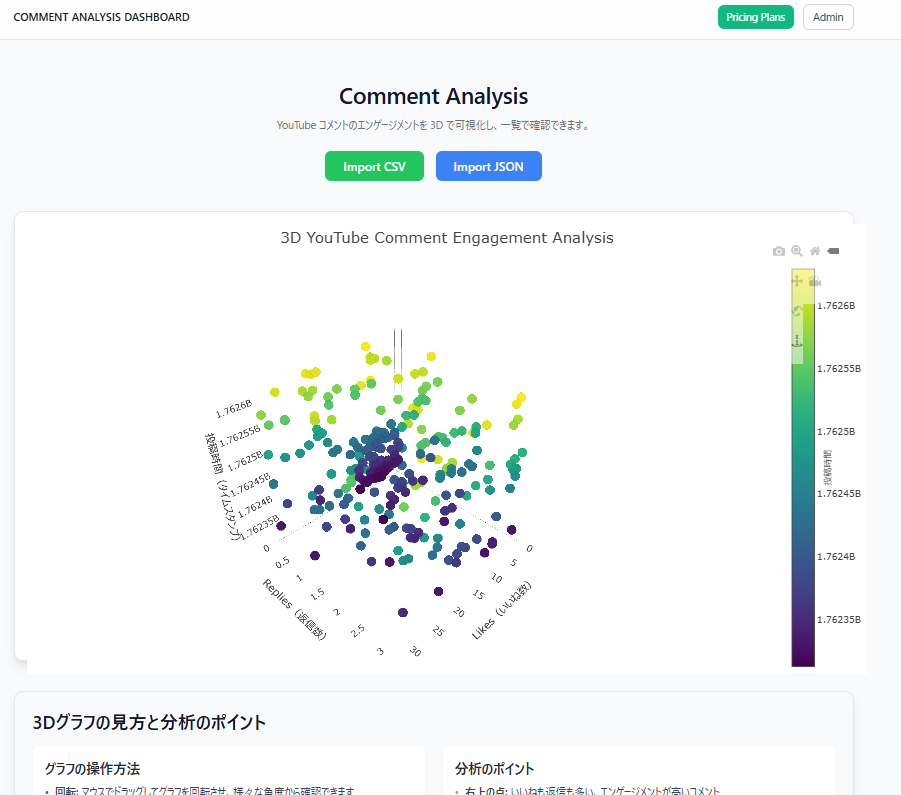
4. 3Dクラスタリング可視化
コメントデータを3次元空間で可視化し、クラスタ構造を直感的に把握できる機能を実装
- TF-IDFベクトル化とPCAによる3次元削減
- k-means法(最大6クラスタ)による自動分類
- 各コメントを小さな点で表示
- クラスタを半透明の大きな球体で表現
- 重なっている点にjitterを適用して可視性を向上
- インタラクティブな3D可視化による直感的なデータ探索
5. クラスタ分析レポート
各クラスタの特徴を自動分析し、解析レポートを生成
- 各クラスタの主要キーワード(最大3つ)を抽出・表示
- サンプルコメントと統計情報を表示
- カード形式のレポート表示による見やすいUI
- 「分析結果と改善アドバイス」セクションに統合
6. スケーラブルなアーキテクチャ
大量データに対応可能なシステム設計
- PostgreSQL + pgvectorによる高速ベクトル検索
- 非同期処理によるEmbedding生成
- キャッシュ機能によるパフォーマンス最適化
- バッチ処理による効率的なデータ更新
成果
技術的成果
- Django × PostgreSQL + pgvector による本格派 AI 分析ダッシュボードの設計と完成
- TF-IDF × PCA による 3D インタラクティブクラスタリング可視化機能の実装
- OpenAI Embedding を統合した文脈検索(Semantic Search)基盤の完工
ビジネス価値
- 膨大な視聴者コメントからの重要要望・課題の自動抽出による分析コストの削減
- 自動生成レポートによるデータ駆動型マーケティング・チャンネル施策の意思決定支援
学び
-
Web × AI・データ構造設計
- Webアプリケーションフレームワーク(Django)とAI・ベクトルDB(pgvector)の親和性の高い結合アーキテクチャの習得
- 大量データ表示における非同期処理と効率的バッチ更新の設計経験
-
UI/UXと可視化の探求
- 単なる表や2Dグラフにとどまらず、3D空間表示やクラスタ記述カードを用いた「見て直感的に伝わる」UI設計の重要性の実感