概要
2026年6月〜8月、Kaggle主催のポケモンカードゲームAIエージェント開発コンペティションに参加。上位プレイヤーの対戦リプレイから行動を学習するAIエージェントを開発し、仮説検証から採択判断までを自動で回すPDCA基盤を構築。
Action Maskingでルール違反・自滅を防ぎ、Champion-Challenger方式によるローカル対戦評価を導入。改善サイクルの高速化を実現。
開発バージョンの変遷
ポケモンカードゲームのプレイ経験がほとんどない状態から着手。ルールを理解しながら段階的に改良し、ルールベース、データ駆動のハイブリッドAIを経て、自動PDCA基盤の構築へ。
| バージョン | アプローチ | 意思決定の仕組み | 評価体制 | 最高スコア |
|---|---|---|---|---|
| v1系 | ルールベース | ヒューリスティクスで行動の優先順位を決定し、rules.pyで自滅を防止 | 目視確認 | 827.9点 |
| v2系 | 教師あり模倣学習 | 上位プレイヤーの同デッキのリプレイを学習し、ScorerNetで行動を選択 | 目視確認 | 557.4点 |
| v3系 | v1・v2のハイブリッド | ルールベース+模倣学習 | 複数試合のリプレイ記録 | 617.3点 |
| v4系 | デッキ拡張と自動PDCA | 定石定義と盤面評価の二経路を統合 | Champion-Challenger | 566.7点 |
自作ダッシュボードによる可視化
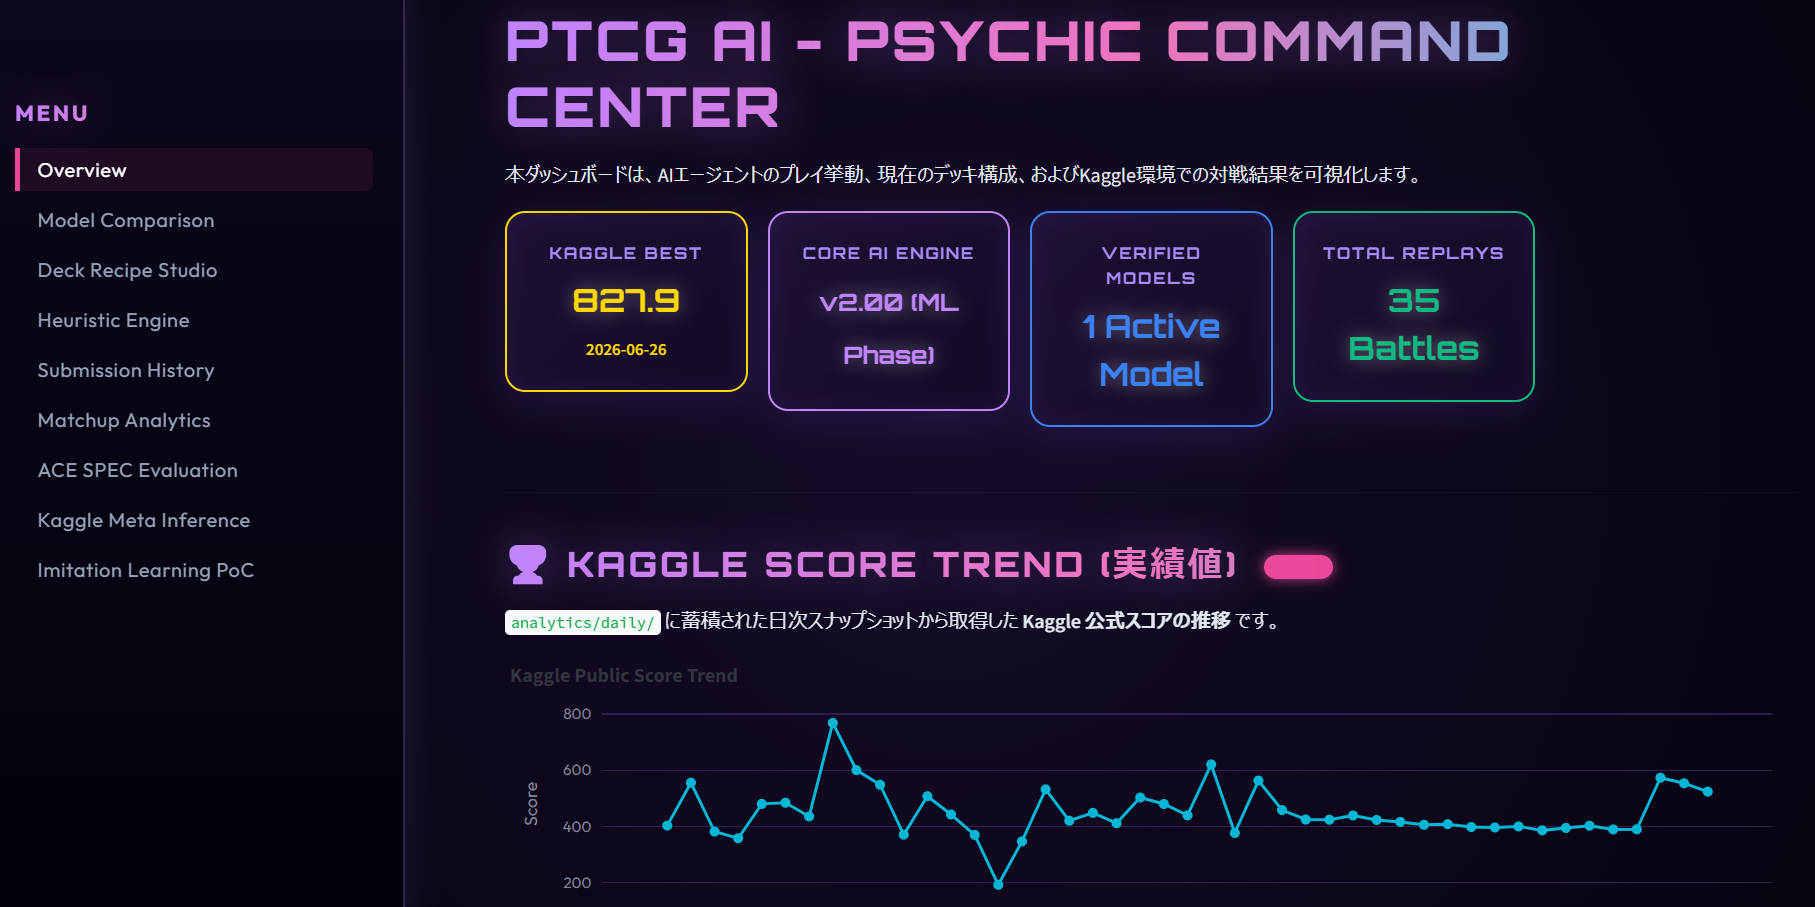
課題の発見と新しい着想のため、開発と並行してStreamlitでダッシュボードを作成(概要のスクリーンショットを参照)。Kaggle最高スコアやモデル構成、対戦履歴を一画面にまとめ、開発中の状況把握に活用。
モジュール構成と責任の分離
保守性と拡張性を高めるため、役割ごとにファイルを分けたモジュール構成(utils/)を採用。
エネルギーの不整合や無効な技の選択など、反則・自滅につながる手を構造的に排除
上位の対戦ログから学習した盤面評価をもとに、最適な行動を選ぶ中核ロジック
統計的検定で、現行モデル(Champion)と候補モデル(Challenger)の採否を自動判定
複数のデッキパターンとの対戦を、ローカルで並列に高速実行
Champion-Challenger方式で回すPDCA
スコアの低下を防ぐため、提出前にローカルで評価するChampion-Challenger方式を採用。本番の観測から採否の判断までを、1変更1仮説で回し続ける仕組みを考案・構築。
PLAN
-
01
本番を観測
公開スコア・本番リプレイ、対面別のKPIと敗因を毎朝9時に同期
-
02
1変更1仮説で候補版を作成
期待効果と評価指標を先に定義し、現行Championを比較基準として固定
DO
-
03
提出前の実行検査
構文・import・60枚デッキを、隔離実行で確認
-
04
Championとの一次選抜
候補版と現行版を直接対戦し、先攻・後攻を各15戦で均等化
不通過:14勝以下は成績を保存し、次の仮説へ
-
05
7対面で標準評価
7デッキ×各50戦、計350戦。先攻・後攻は各25戦
山札切れ(LO)での勝敗も診断し、勝率の差の95%信頼区間で通過可否を判定
不通過:175勝以下は成績を保存し、次の仮説へ
CHECK
-
06
提出前レビュー
代表試合を確認し、提出可否を最終判断
-
07
Kaggle本番で検証
Kaggle APIで自動提出し、直後にGitHubへ自動でpush
約5時間後、公開スコアと本番リプレイで現行版と比較
ACT
本番で改善したか(現行版と比較)
YES
Championを更新
採用版と版台帳を更新し、次の本番観測へ
NO
記録して次の仮説へ
勝敗・対面別KPI・失敗理由を保存し、現行Championを維持
不採用の結果も削除しない。
成果
- 自滅行動の防止率100%
- Kaggle最高スコア827.9点
- 人手のテストプレイを不要にし、無人の並列実行でモデルを自動選抜
- ローカルテストから提出・git pushまでを自動化し、検証サイクルを短縮
学び
-
責任の境界を分ける設計
ルール制約、予測モデル、評価を別の層に分けたことで、改良しやすく壊れにくい基盤に。この考え方は、ほかの開発や組織運営にも応用できると実感。
-
人の手を挟まない検証サイクル
API連携とローカルの並列シミュレーションで、仮説から評価・提出までを自動化。検証のリードタイム短縮と再現性の向上を両立。
-
感覚ではなく統計で決める
単発の勝ち負けに振り回されないよう、リプレイの日次取得と勝率差の信頼区間を判断に組み込み、採否の基準を明確化。
-
可視化で課題の場所を特定
盤面の推移や勝率の構造をダッシュボードで見える化し、改善点の検討に活用。